DHI 種子基金 · 2025 秋 · 預計 2026 年春上線
滿文光學字元辨識與翻譯人工智能
一套能從真實史料中讀取與切分滿文的自動系統:以微調過的視覺語言模型為基礎,並往轉寫與機器翻譯推進。
計劃在做什麼
讓一套沒有現成工具可用的文字,能夠被自動讀取。
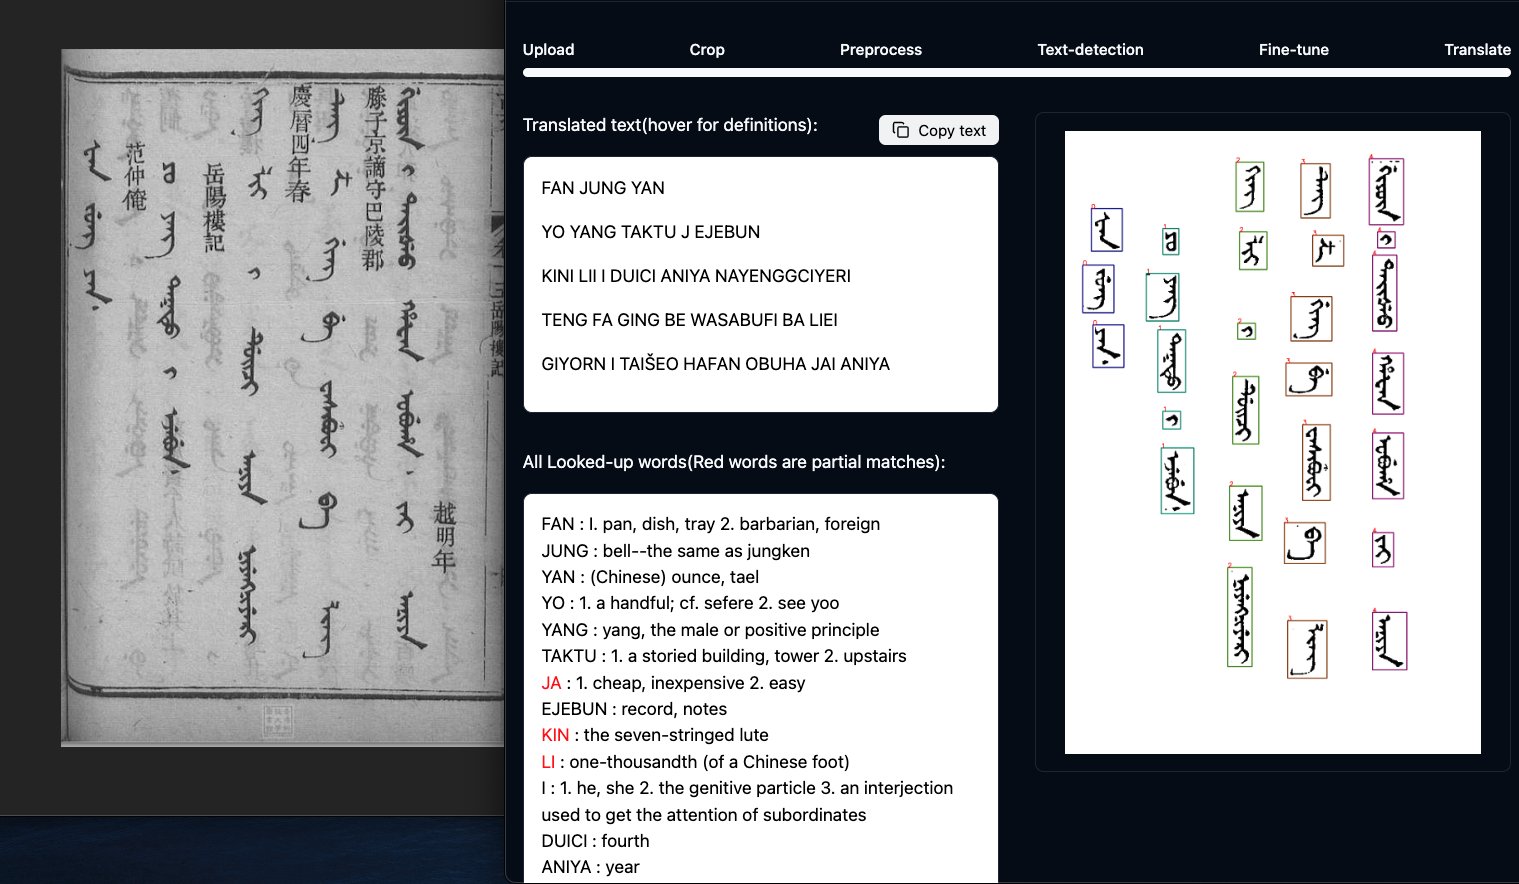
本計劃要建立一套可靠且高準確度的系統,能從真實史料中讀取並切分滿文。它建立在自訂的分詞流程之上,背後是從多個典藏機構蒐集而來、合成與真實掃描並重的大量語料。
這些工作已經產出一個微調過的視覺語言模型,在真實掃描材料上表現良好。早期測試顯示它能辨識印刷體與書寫工整的檔案頁,這正是現代 OCR 能被用在一種低資源文字上的關鍵,儘管它有著複雜的豎排結構與多變的書體。
進展
-
已完成
微調後的視覺語言模型
以合成與真實掃描訓練,前端接上自訂的分詞流程;能讀取印刷體與書寫工整的檔案頁。
-
下一步
擴充資料,再接上管線
擴大訓練語料並強化表現,然後把 OCR 的輸出接到轉寫與機器翻譯。
-
成果
讓檔案成為可檢索的文字
一個實用工具:把滿文檔案轉成可檢索、可分析的文字;同時留下一套可轉移到其他瀕危或低資源語言的 OCR 框架。
團隊
- 首席研究員
- Prof. Michael CHUNG,人文學部
- 研究助理
- Hanlin WANG,資訊科技、計算機科學及工程學系學生
- 計劃支援
- Dr. Steve MA,人文學部Yifan WANG,圖書館