2025 秋季 · HUMA5630 · 命名實體識別
命名實體辨識模型在文學領域的應用
三個模型,一部中文小說。這個計劃教機器在現當代文學裡標出人、地與作品,然後問:讀者只能感覺到的東西,機器看得見多少?
一行文字,四類實體
在上海LOC,淮海路LOC與國泰戲院LOC之間,金宇澄PER寫下《繁花》WORK。
在上海淮海路與國泰戲院之間,金宇澄寫下《繁花》。
- PER人物
- LOC地名
- ORG機構
- WORK作品
三個模型,同一份訓練資料
| 模型 | 準確率 | 詞級 token | 實體級 entity | ||||
|---|---|---|---|---|---|---|---|
| P | R | F1 | P | R | F1 | ||
| CRF | 0.8526 | 0.5619 | 0.4883 | 0.5156 | 0.6926 | 0.6049 | 0.6458 |
| BERT-Tiny | 0.8698 | 0.5648 | 0.5248 | 0.5420 | 0.6037 | 0.6370 | 0.6199 |
| BERT-Base | 0.8939 | 0.6299 | 0.6024 | 0.6011 | 0.6908 | 0.7242 | 0.7071 |
三個模型共用同一份訓練資料:約 4,800 句、近一百萬行。詞級以每個詞計分,實體級以整個實體計分;準確率兩級相同,所以只列一次。
數碼人文學生項目(2025 年秋季)。本項目為 HUMA5630「數碼人文」課程的課程項目。
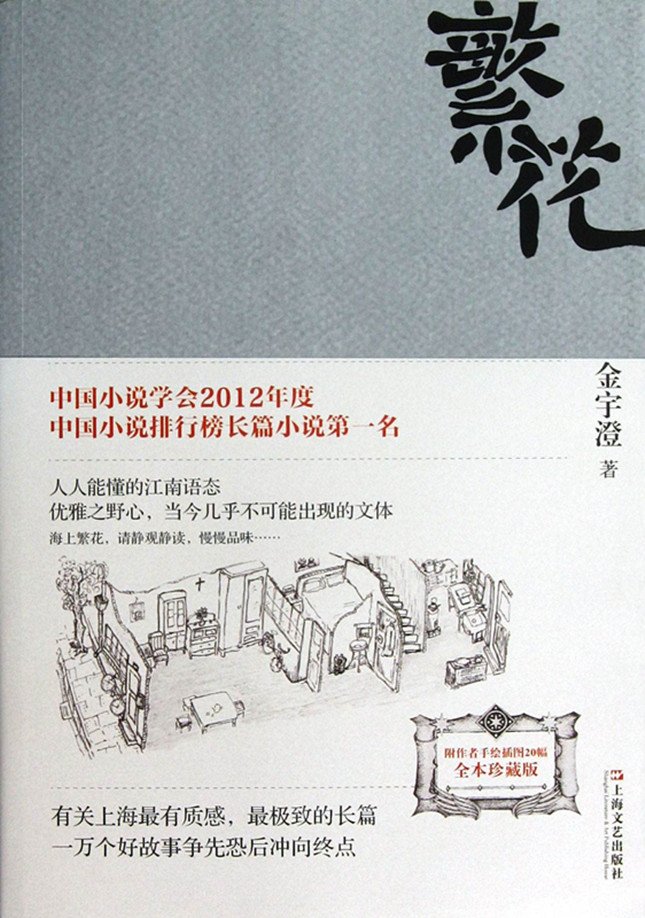
金宇澄小說《繁花》書封
01關於本項目
- 本項目旨在為中國現當代文學建立命名實體辨識(NER)模型,藉此探索 NER 在輔助文學研究方面的價值。
- 以中文文本為輸入,期望模型能逐字掃描文本,並辨識其中的人物、地點、概念、時間等實體。這就是命名實體辨識(NER)任務。
02可能應用:地理批評
- 一種針對文學文本的空間批評方法。
- 結合中國文學與地理研究的跨學科成果。
- 我們可運用 NER 協助辨識文學作品中的地名,從而建構特定文學的地理空間,並理解該地方的文學記憶。
03CRF 模型
- CRF 的全稱是條件隨機場(Conditional Random Fields,CRF),是一種用於序列資料標註與切分的機率圖模型。它屬於判別式模型,即直接為給定輸入序列下的輸出標註序列的條件機率建模,而不對輸入的整體分佈建模。
- 簡單來說,CRF 透過考慮相鄰標籤之間的依賴關係,為每一個位置賦予最合理的標籤。
04BERT 模型
BERT-Tiny
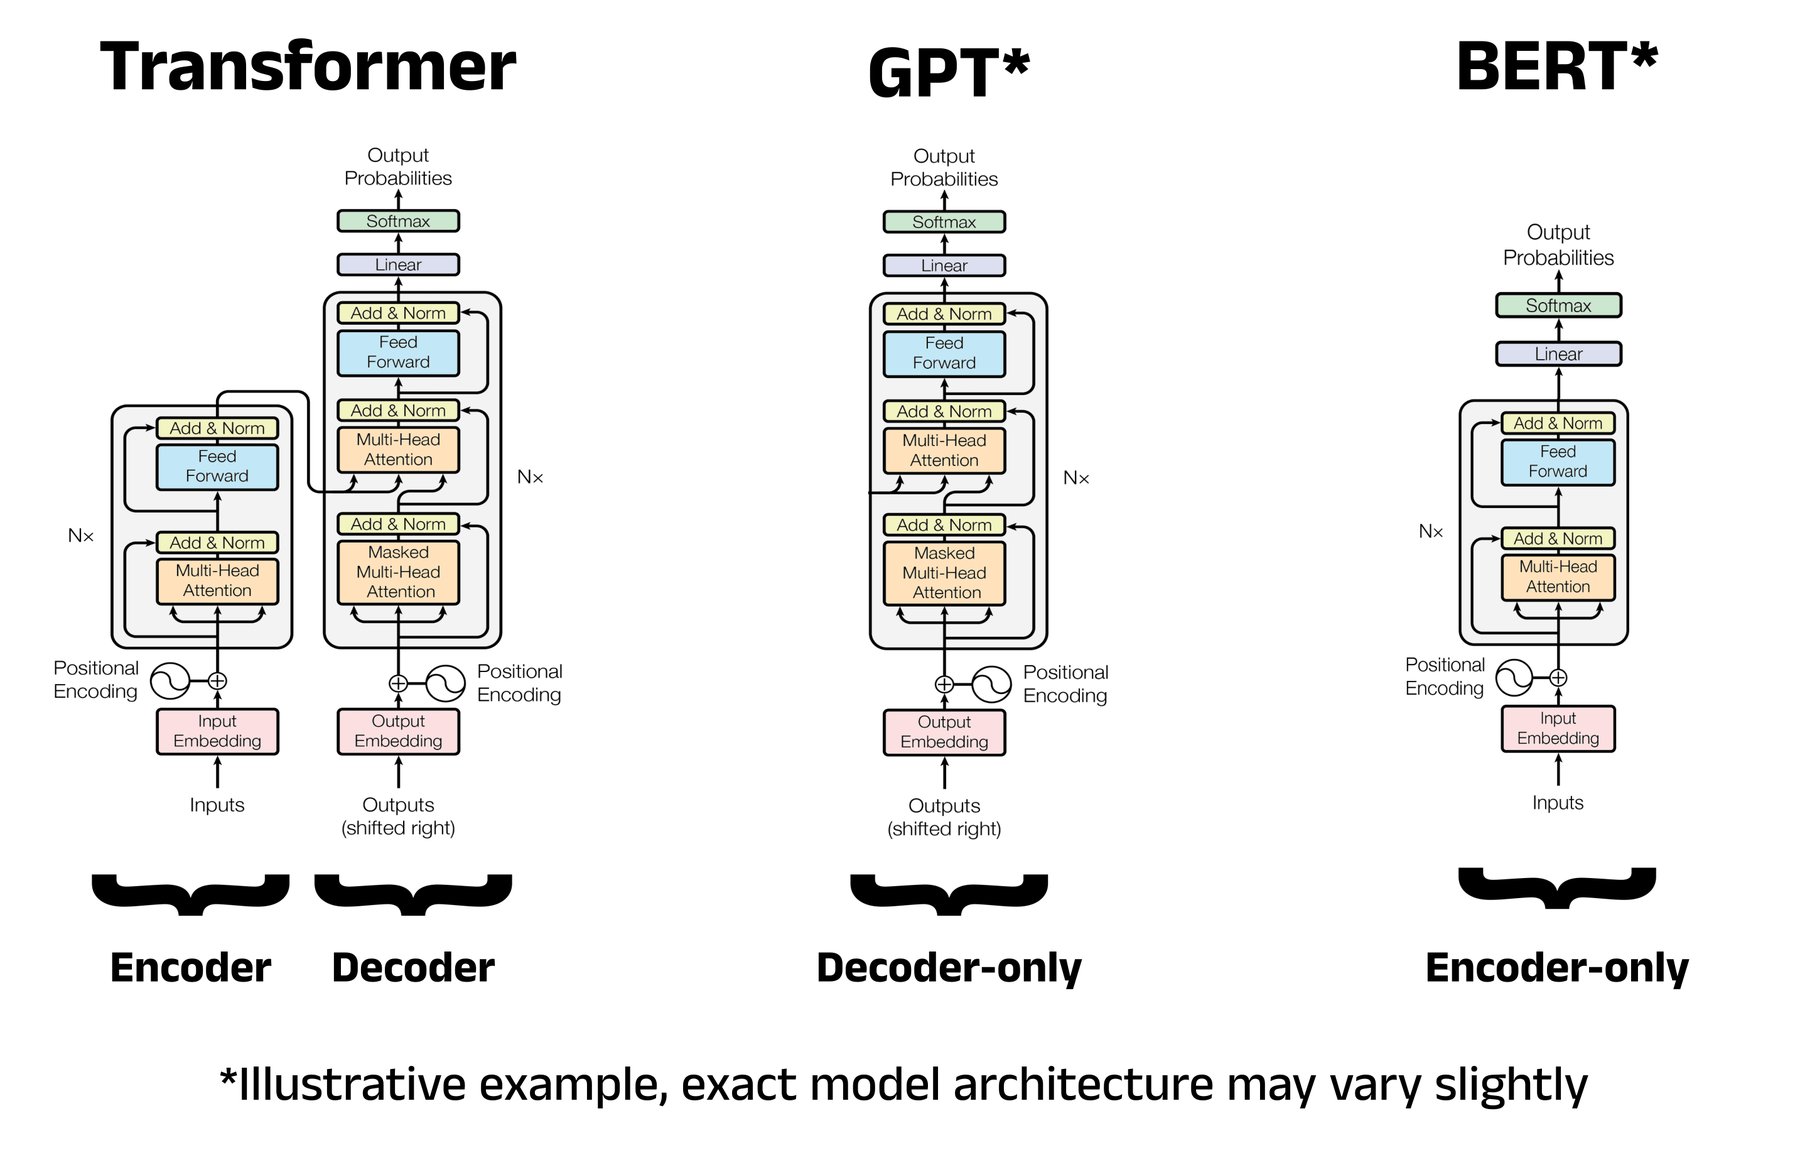
- 採用開源模型 https://huggingface.co/ckiplab/bert-tiny-chinese-ner,該模型由 CKIP Lab 以 BERT-Tiny Chinese 微調而成,支援繁體中文。
- BERT 模型基本資料:12M 參數、4 層、隱藏層維度為 312;
- 額外分類層:312 維 → 73 維,將詞元分類為 73 個實體標籤。
BERT-Base
- 採用開源模型 https://huggingface.co/ckiplab/bert-base-chinese-ner,該模型由 CKIP Lab 基於 BERT Base Chinese 微調,支援繁體中文。
- BERT 模型基本資料:110M 參數、12 層、隱藏層維度為 768;
- 額外分類層:768 維 → 73 維,將詞元分類為 73 個實體標籤。
- CRF 模型 —— 訓練耗時:15 分鐘;推論速度(token/s):約 9407
- BERT-Tiny —— 訓練耗時:15 分鐘;推論速度(token/s):約 14940
- BERT-Base —— 訓練耗時:約 1 小時;推論速度(token/s):約 3715
05結果比較
- CRF 模型的訓練環境(使用 CPU):Intel(R) Core(TM) i5-9300H CPU @ 2.40GHz(8G)
- bert-tiny 及 bert-base 模型的微調環境(使用 GPU):NVIDIA GeForce RTX 4090(24G)
- 訓練集數量:約 4800 句,合共 100 萬行
06詞元
- CRF —— 準確度 0.8526;精確度 0.5619;召回率 0.4883;F1 分數 0.5156
- bert-tiny —— 準確度 0.8698;精確度 0.5648;召回率 0.5248;F1 分數 0.5420
- bert-base —— 準確度 0.8939;精確度 0.6299;召回率 0.6024;F1 分數 0.6011
Transformer、GPT 與 BERT 架構的比較。圖片由作者根據《Attention is All You Need》論文中的 Transformer 架構圖改編
07實體
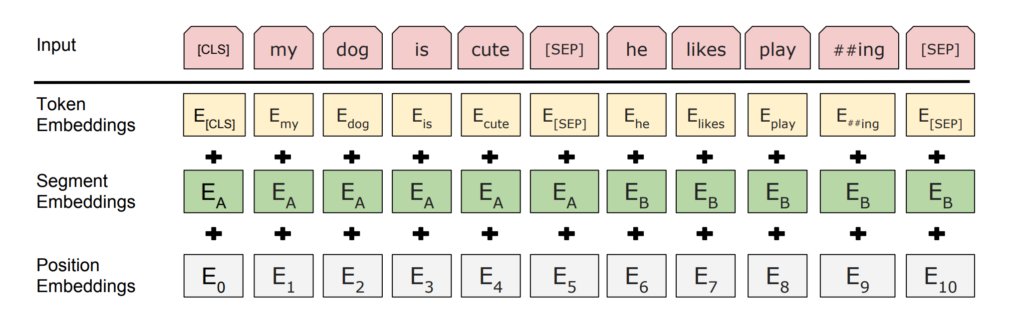
BERT 嵌入過程概覽。圖片取自 BERT 論文
- CRF —— 準確度 0.8526;精確度 0.6926;召回率 0.6049;F1 分數 0.6458
- bert-tiny —— 準確度 0.8698;精確度 0.6037;召回率 0.6370;F1 分數 0.6199
- bert-base —— 準確度 0.8939;精確度 0.6908;召回率 0.7242;F1 分數 0.7071
實際應用
運用 NER,我們可以更精確、更有系統地建構文學中的地理空間。
例如,我們可以自動擷取實體:迅速辨識文本中的地名,如「lan」、「曹楊新村」和「蘇州河」,避免人手標註時有所遺漏。
我們也可以建構空間關係網絡:透過辨識地名的共現關係(例如「淮海路」與「國泰電影院」經常同時出現),揭示上海「上只角」(盧灣區)與「下只角」(華溪區)的空間分化,有助於「地理與文學」層面的空間層級分析。
透過分析某一地區文學中常見的地名(例如廣州的「Jiuzhou」與「西關」,以及成都的「茶館」與「錦里」),可以提取該城市的「文學地標」,為地方文化品牌建設提供素材(例如以「邊城」作為湘西旅遊文化的文學 IP)。
具體例子:《Yan Food Diary》與《Like a Seal and a Jade》均於近年出版,兩者都聚焦嶺南的城市文學。透過 NER 實體辨識發現,兩者在書寫嶺南時都反覆出現相同地名,例如「Jiuzhou」同時見於兩部文學作品之中。
08學生
- WU Wen-shin — 中國文化文學碩士
- LIANG Xiaojing — 中國文化文學碩士
- LI Jialu — 社會科學文學碩士
- TSOI Sin Yu — 中國文化文學碩士
09GitHub 代碼庫
詳細代碼及項目文檔請見以下連結。
模型從文學裡拉出來的地名
- 九洲
- 西關
- 茶館
- 錦里
- 邊城
- 蘇州河
- 曹楊新村
- 淮海路
- 國泰戲院
- 弄
模型在這些小說裡認出的地名,也是把「文本記住的地理」畫成地圖的原料。
發現
「九洲」在兩部小說裡都出現。兩本寫嶺南的書,反覆用到同一批地名:這種重複,讀者容易錯過,標註器卻一抓就中。
實際用途 · 文學地理學