口述文本 · 數位化 · 標準化
同一文字 的阿卡之聲
阿卡口傳傳統浩瀚,但每位研究者記錄下來的拼寫都不一樣。本計劃把這些拼寫收攏到同一套文字,並把文本譯成英文與中文。
- 5份研究者檔案
- 1套共同正字法(CAO)
- 3種源語言 → 英文
- 1950s自五〇年代開始記錄
背景
阿卡人與口傳傳統
阿卡人是操藏緬語族語言的民族,分佈於雲南、老撾、泰國、緬甸與越南一帶的高地。他們的社群承載著一套口傳的儀式文本 —— 吟唱、譜系與禱詞 —— 在其歷史的大部分時間裡,這些文本只存在於儀式現場,以及前來記錄的研究者的筆記本中。
為何需要同一套文字
由於每位研究者記錄阿卡語的方式都不同,同一段文本看起來會像好幾種語言。在一份檔案裡記下的詞,無法與另一份檔案互相檢索;一九七〇年代轉寫的吟唱,也難以與五十年後的錄音對齊。把各種轉寫收攏到同一套正字法,正是讓語料庫具備可比性的前提 —— 最終也才有翻譯的可能。
工作如何進行
手寫頁面先以光學字元辨識轉成打字文本,這一步由語言模型與人工校對分工完成;接著把舊有拼寫轉換為「共同阿卡正字法」;僅存於中文、德文或泰文的文本,再譯成英文。每一道工序都依賴前一道,因此本計劃把它們視為一條工序鏈,而不是彼此獨立的工作。
下一步走向何處
下一步是聲音:把錄下來的口傳文本與吟唱轉成 CAO 打字文本,也就是要讓系統聽懂儀式語域,而不只是日常會話。老撾豐沙里的新田野工作,將帶回從未被寫下來的材料。
問題
阿卡人分佈於雲南、老撾、泰國、緬甸與越南的高地。其儀式文本自五〇年代起被記錄,但不同時期、不同地區的研究者採用了各異而個人化的拼寫系統 —— 這令彼此比較十分困難,也使大量文本始終沒有譯本。
工作
- 以光學字元辨識(OCR)將手寫材料數碼化。
- 以人工智能輔助,把舊有拼寫轉寫為「共同阿卡正字法」(CAO)。
- 以數碼翻譯工具,把中文、德文與泰文文本譯成英文。
工序鏈
每一道工序,把成果交給下一道。
- 手寫頁面
- OCR · 大模型+人工
- 打字文本
- CAO 轉換
- 英文/中文
檔案
五份收藏構成語料庫。
- Inga-Lill Hansson
- Jacob Terrell
- Friedhelm Scholz
- Giulio Ongaro
- 袁明澤
下一步
- 為錄音的口傳文本與吟唱開發語音轉文字。
- 把吟唱錄音轉成 CAO 打字文本。
- 新的翻譯工具:CAO 轉英文與中文。
- 在老撾豐沙里展開新的田野研究。
五種筆跡、同一傳統的五種拼寫 —— 全部轉換為同一套正字法。
計劃影像
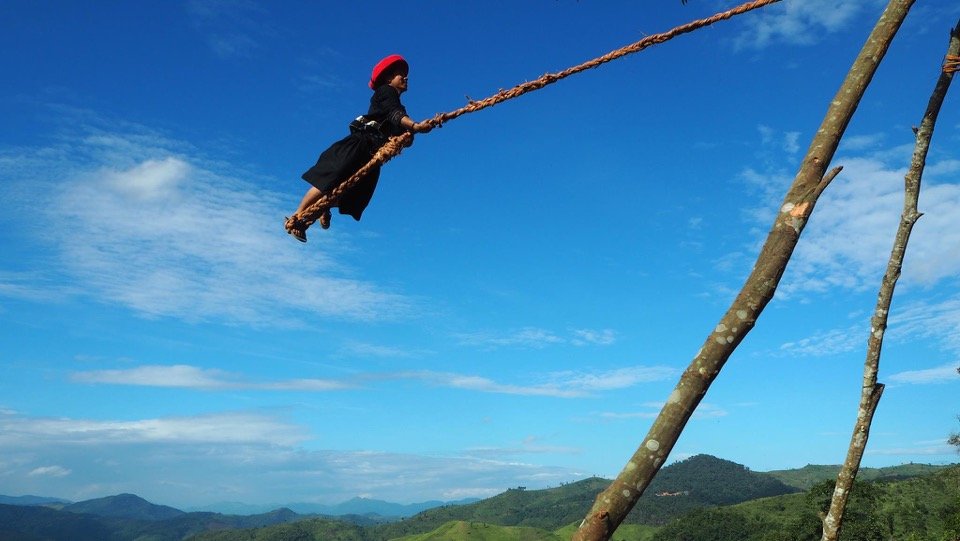
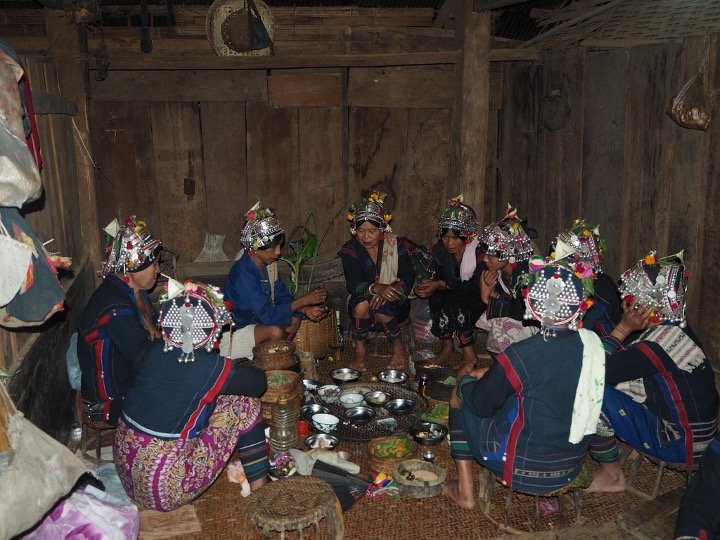
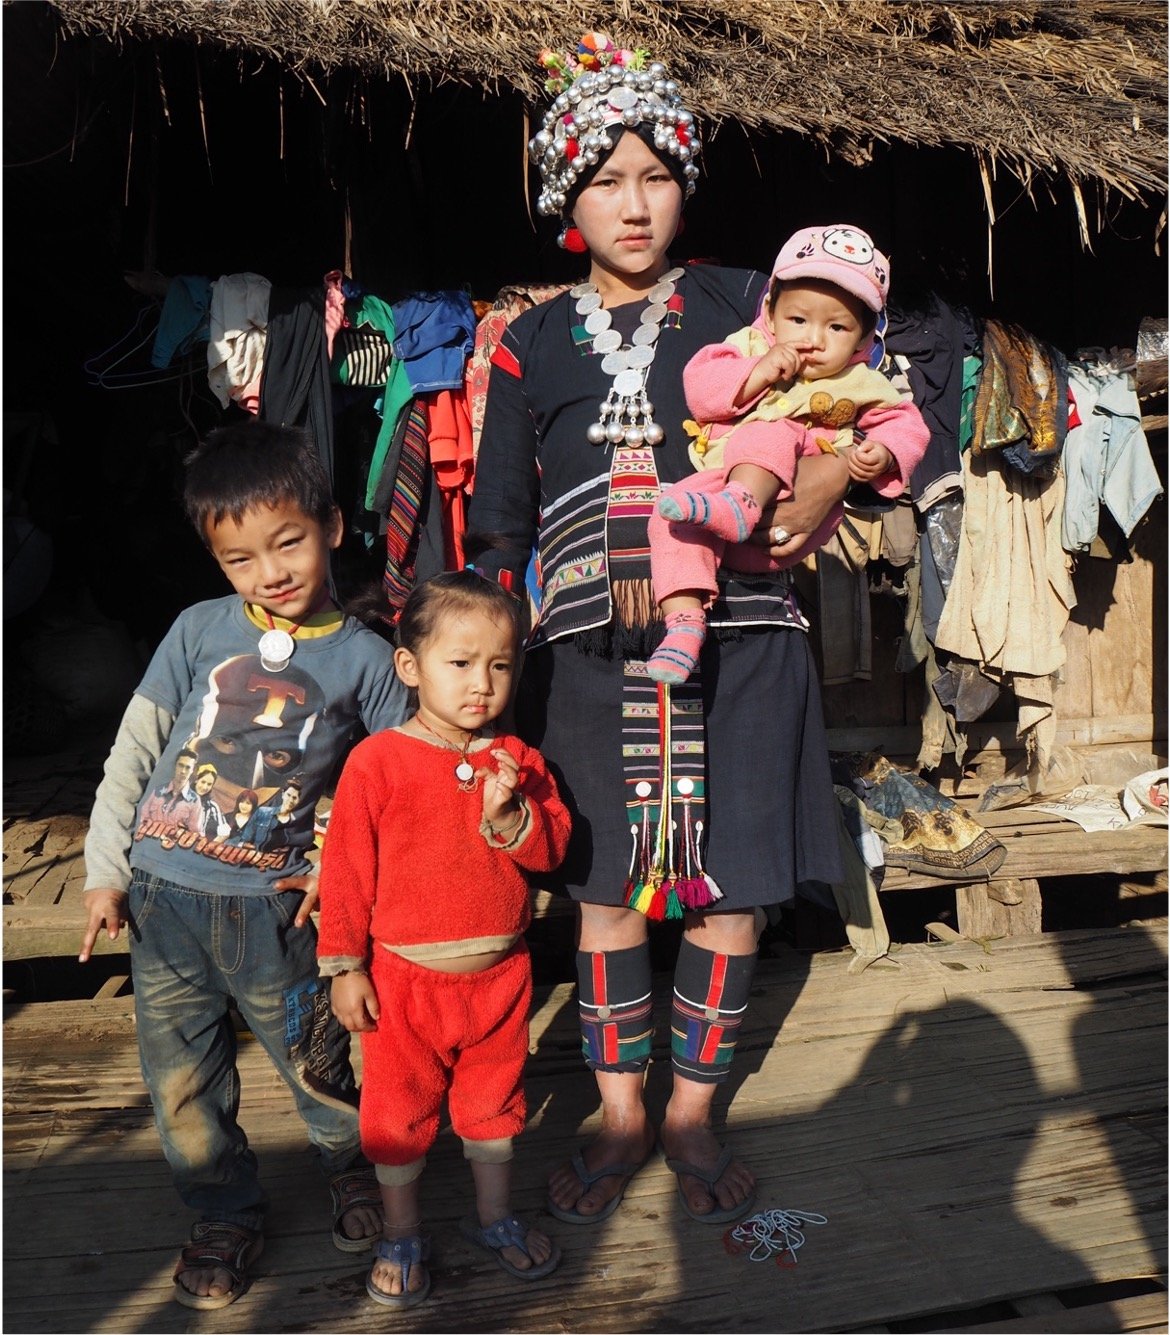
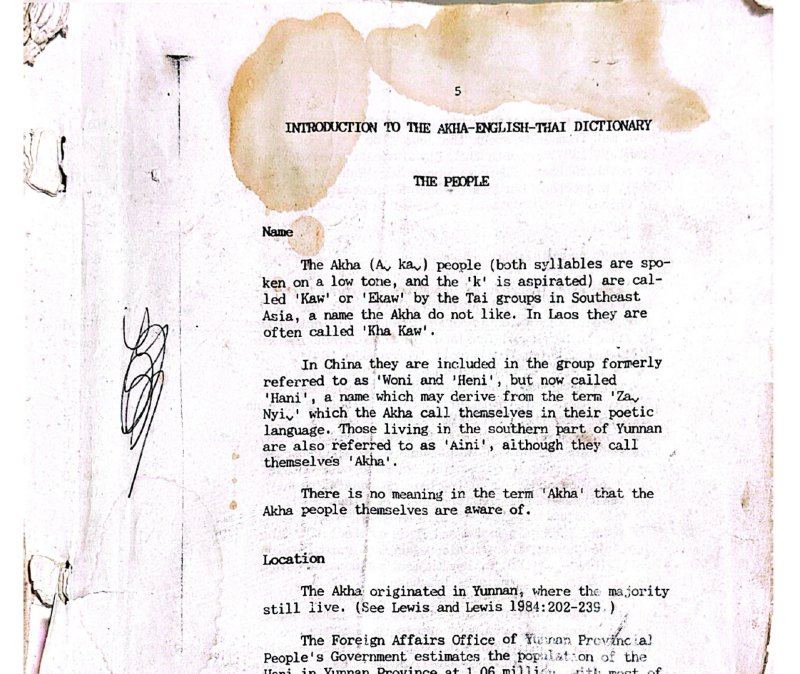
計劃所見:手稿頁面與阿卡高地。
團隊
首席研究員
- Prof. Giulio ONGARO — 人文學部
學生實習生
- Ashab RIBAT — 工程學
- David ABRAHAM — 工程學
- Mariia ROGOZINA — 嶺南大學當代英語研究
計劃支援
- Dr. Steve MA — 人文學部
- Yifan WANG — 圖書館
檔案與文獻
- Hansson、Terrell、Scholz、Ongaro 與袁明澤的阿卡口傳文本檔案。
- Paul Lewis《阿卡—英—泰詞典》(1989)—— 已掃描、OCR 並轉換為 CAO。
- 阿卡攝影:Prof. Giulio Ongaro。