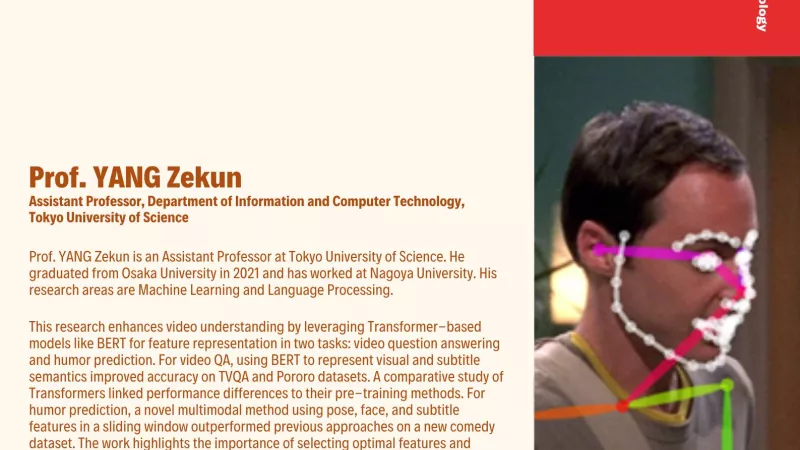
首頁 活動 10月 17 2025 視覺與語言的表徵學習:邁向更深層的影片理解 2025年10月17日(星期五) 16:30 – 18:00 Room 4402 講者 Prof. YANG Zekun (Tokyo University of Science) 東京理科大學楊澤坤教授介紹以 Transformer 模型進行影片問答與幽默預測的研究。 東京理科大學資訊與電腦科技系楊澤坤教授介紹其研究:以 BERT 等 Transformer 模型進行特徵表徵,應用於影片問答與幽默預測兩項任務,藉此提升機器對影片內容的理解能力,並討論視覺與語言表徵的結合方向。 研討會 返回所有活動